Domain jeci.de kaufen?
Wir ziehen mit dem Projekt
jeci.de um.
Sind Sie am Kauf der Domain
jeci.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain jeci.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **

Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Rowenta, Glätteisen, Haarglätter, tolle Erfahrung• Der integrierte Kamm von den Wurzeln bis zu den Haarspitzen führt das Haar durch die 3D-Floating-Platten, die so konzipiert sind, dass sie einen konstanten und optimalen Kontakt mit dem Haar gewährleisten; • Rowentas vielseitiges Werkzeug, das dank des abnehmbaren Kamms für jeden Wunsch geeignet ist, ermöglicht es Ihnen, im Handumdrehen vom Glätten zum Locken zu wechseln; • Keramikplatten fördern eine gleichmäßige Wärmeableitung zwischen den Platten; der integrierte Mikroprozessor überwacht die Temperatur und passt sie an, um während der gesamten Glättungssitzung eine konstante Wärme aufrechtzuerhalten; • Genießen Sie maximale Vielseitigkeit und Präzision mit fünf Temperatureinstellungen (120, 140, 160, 180, 200). Niedrige Temperaturen von 120 ° und 140 ° begrenzen die Hitze und ermöglichen eine Anpassung zwischen zwei Bügelvorgängen; • Aufwärmzeit von nur 25 Sekunden für einen perfekten Look im Handumdrehen und ein ultrakompaktes Reiseformat mit extra langem Kabel, damit Sie Ihrer Kreativität überall und jederzeit freien Lauf lassen können.74,43 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Geschlecht als gelebte Erfahrung, FachbücherGeschlecht ist keine abstrakte Kategorie, sondern gelebte Erfahrung - und in vielen Situationen eine Frage von Anerkennung, Versorgung und Sprache. Wer über trans*, inter* und queere Lebensweisen spricht, berührt immer auch Medizin und Psychotherapie, Recht und Politik, Biografien und Körper. In kurzen, gut zugänglichen Texten geben die Autor*innen Ein- und Ausblicke in die trans* und queere (Gesundheits-)Versorgung, in psychotherapeutische und psychoanalytische Perspektiven sowie in soziologische und rechtliche Einordnungen. Zeitgeschichtliche Rückblicke sowie Beiträge zu Medien, Kunst und Körper vervollständigen das Panorama. So entsteht ein vielstimmiger Band, der nicht verkürzt, sondern differenziert und gerade dadurch eine tiefere Einsicht in professionelle, politische und private Erfahrungen mit geschlechtlicher Variation ermöglicht. Der Band ist Annette Güldenring gewidmet, die sich seit Jahrzehnten an der Schnittstelle von klinischer Praxis, Forschung und Engagement für eine menschenwürdige Versorgung und für geschlechtliche Vielfalt einsetzt. Mit Beiträgen von Julia Bohr, Angelika Eck, Johannes Fuss, Annette Güldenring, Susanne Krege, Richard Kühl, Phil C. Langer, Richard Lemke, Lieselotte Mahler, Anna Katharina Mangold, Götz Mundle, Timo Nieder, Niclas O'Donnokoé, Friedemann Pfäfflin, Wilhelm F. Preuss, Udo Rauchfleisch, Arn Sauer, Gunter Schmidt, Hannah Schütz, Katinka Schweizer, Wolfgang Senf, Mick van Trotsenburg, Lucie G. Veith und Paula-Irene Villa.39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Umbildende Erfahrung, Fachbücher von Jörg SoetebeerDas Fachbuch "Umbildende Erfahrung" von Jörg Soetebeer bietet eine tiefgehende Analyse von Johann Wolfgang von Goethes Konzept der Selbstbildung. Es untersucht, wie Goethe Selbstbildung als eine erfahrungsbasierte Umbildung verstand und diese in seiner Erkenntnispraxis umsetzte. Die naturphilosophischen und ästhetischen Schriften Goethes dienen als Grundlage für die Rekonstruktion seiner Bildungspraxis. Dabei wird die Wahrnehmung als eine spezifische Form der Erkenntnis hervorgehoben, die vor den Verarbeitungsprozessen des Verstandes steht. Das Buch beleuchtet zentrale Begriffe wie Gestalt, Genie und Ganzheit und bietet eine Neubewertung dieser Konzepte im Kontext von Goethes Bildungsanspruch. Es richtet sich an Leser*innen, die sich für die Schnittstellen von Ästhetik, Philosophie und Bildung interessieren und bietet wertvolle Einblicke in Goethes Denken.65,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
ANGEBOT Beige Design-Sessel MIZU II. QualitätANGEBOT Beige Design-Sessel MIZU II. Qualität. Material Bezugskomposition: 100% Polyester Bezugsstoff: Chenillestoff Bezug: ALIA 18 Abriebfestigkeit (Martindale): 50.000 Buchenholz: Walnussoptik Maße Breite: 64 cm Tiefe: 62 cm Höhe: 73 cm Sitzhöhe: 45 cm Sitztiefe: 52 cm Sitzbreite: 49 cm Produktdetails Design-Sessel im minimalistischen Stil Farbkombination im natürlichen Geist Bezug mit feiner Struktur und Melange von Farben Hydrophobe Behandlung des Bezugs und leichte Reinigung Beine aus massivem Buchenholz in Walnussoptik ALIA Der Bezugsstoff ALIA besticht durch sein elegantes Aussehen und seine feine Struktur, die sowohl visuell als auch haptisch angenehm wirken. Er wird aus zwei unterschiedlichen Garnsorten hergestellt – einem dominanten, weichen Chenillegarn und einem ergänzenden Garn mit feinerer Webart. Diese Kombination erzeugt einen dezenten plastischen Effekt und eine natürliche Farbtiefe. Der Stoff besteht aus 100% Polyester und bietet ein Gewicht von 430 g/m², was ihn zur idealen Wahl für Polstermöbel macht. Zu den Hauptvorteilen des ALIA Stoffes gehört seine hohe Widerstandsfähigkeit gegen Abnutzung – laut Martindale-Test hält er 50.000 Zyklen stand, was seine lange Lebensdauer auch bei häufigem Gebrauch garantiert. Die hohe Qualität wird durch eine Farbkonstanz auf der Stufe 4 und eine Pillingbewertung ebenfalls von 4 ergänzt, wodurch der Stoff sein ursprüngliches Erscheinungsbild über lange Zeit beibehält. Farbe:Beige Material:Gepolstert196,70 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter
-
Rowenta, Glätteisen, Haarglätter, tolle Erfahrung• Der integrierte Kamm von den Wurzeln bis zu den Haarspitzen führt das Haar durch die 3D-Floating-Platten, die so konzipiert sind, dass sie einen konstanten und optimalen Kontakt mit dem Haar gewährleisten; • Rowentas vielseitiges Werkzeug, das dank des abnehmbaren Kamms für jeden Wunsch geeignet ist, ermöglicht es Ihnen, im Handumdrehen vom Glätten zum Locken zu wechseln; • Keramikplatten fördern eine gleichmäßige Wärmeableitung zwischen den Platten; der integrierte Mikroprozessor überwacht die Temperatur und passt sie an, um während der gesamten Glättungssitzung eine konstante Wärme aufrechtzuerhalten; • Genießen Sie maximale Vielseitigkeit und Präzision mit fünf Temperatureinstellungen (120, 140, 160, 180, 200). Niedrige Temperaturen von 120 ° und 140 ° begrenzen die Hitze und ermöglichen eine Anpassung zwischen zwei Bügelvorgängen; • Aufwärmzeit von nur 25 Sekunden für einen perfekten Look im Handumdrehen und ein ultrakompaktes Reiseformat mit extra langem Kabel, damit Sie Ihrer Kreativität überall und jederzeit freien Lauf lassen können.74,43 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Geschlecht als gelebte Erfahrung, FachbücherGeschlecht ist keine abstrakte Kategorie, sondern gelebte Erfahrung - und in vielen Situationen eine Frage von Anerkennung, Versorgung und Sprache. Wer über trans*, inter* und queere Lebensweisen spricht, berührt immer auch Medizin und Psychotherapie, Recht und Politik, Biografien und Körper. In kurzen, gut zugänglichen Texten geben die Autor*innen Ein- und Ausblicke in die trans* und queere (Gesundheits-)Versorgung, in psychotherapeutische und psychoanalytische Perspektiven sowie in soziologische und rechtliche Einordnungen. Zeitgeschichtliche Rückblicke sowie Beiträge zu Medien, Kunst und Körper vervollständigen das Panorama. So entsteht ein vielstimmiger Band, der nicht verkürzt, sondern differenziert und gerade dadurch eine tiefere Einsicht in professionelle, politische und private Erfahrungen mit geschlechtlicher Variation ermöglicht. Der Band ist Annette Güldenring gewidmet, die sich seit Jahrzehnten an der Schnittstelle von klinischer Praxis, Forschung und Engagement für eine menschenwürdige Versorgung und für geschlechtliche Vielfalt einsetzt. Mit Beiträgen von Julia Bohr, Angelika Eck, Johannes Fuss, Annette Güldenring, Susanne Krege, Richard Kühl, Phil C. Langer, Richard Lemke, Lieselotte Mahler, Anna Katharina Mangold, Götz Mundle, Timo Nieder, Niclas O'Donnokoé, Friedemann Pfäfflin, Wilhelm F. Preuss, Udo Rauchfleisch, Arn Sauer, Gunter Schmidt, Hannah Schütz, Katinka Schweizer, Wolfgang Senf, Mick van Trotsenburg, Lucie G. Veith und Paula-Irene Villa.39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Umbildende Erfahrung, Fachbücher von Jörg SoetebeerDas Fachbuch "Umbildende Erfahrung" von Jörg Soetebeer bietet eine tiefgehende Analyse von Johann Wolfgang von Goethes Konzept der Selbstbildung. Es untersucht, wie Goethe Selbstbildung als eine erfahrungsbasierte Umbildung verstand und diese in seiner Erkenntnispraxis umsetzte. Die naturphilosophischen und ästhetischen Schriften Goethes dienen als Grundlage für die Rekonstruktion seiner Bildungspraxis. Dabei wird die Wahrnehmung als eine spezifische Form der Erkenntnis hervorgehoben, die vor den Verarbeitungsprozessen des Verstandes steht. Das Buch beleuchtet zentrale Begriffe wie Gestalt, Genie und Ganzheit und bietet eine Neubewertung dieser Konzepte im Kontext von Goethes Bildungsanspruch. Es richtet sich an Leser*innen, die sich für die Schnittstellen von Ästhetik, Philosophie und Bildung interessieren und bietet wertvolle Einblicke in Goethes Denken.65,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
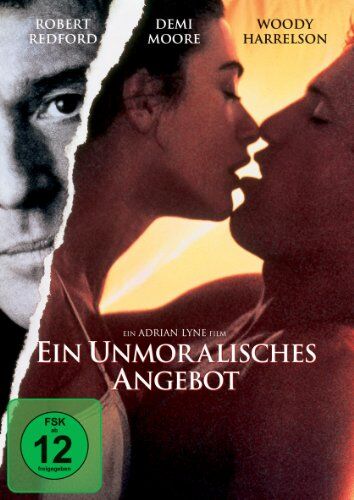
Adrian Lyne - Ein unmoralisches Angebot - Preis vom 26.10.2026 08:27:14 hAspectRatio : 1.78 : 1, AudienceRating : Freigegeben ab 12 Jahren, Brand : Paramount, Binding : DVD, Label : Paramount Home Entertainment, Publisher : Paramount Home Entertainment, NumberOfDiscs : 1, RegionCode : 2, Format : PAL, Feature : Jahr : 1993, medium : DVD, releaseDate : 2006-05-04, runningTime : 112 minutes, theatricalReleaseDate : 1993-04-07, writers : Jack Engelhard, actors : Robert Redford, Demi Moore, Woody Harrelson, directors : Adrian Lyne, music : John Barry3,69 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.